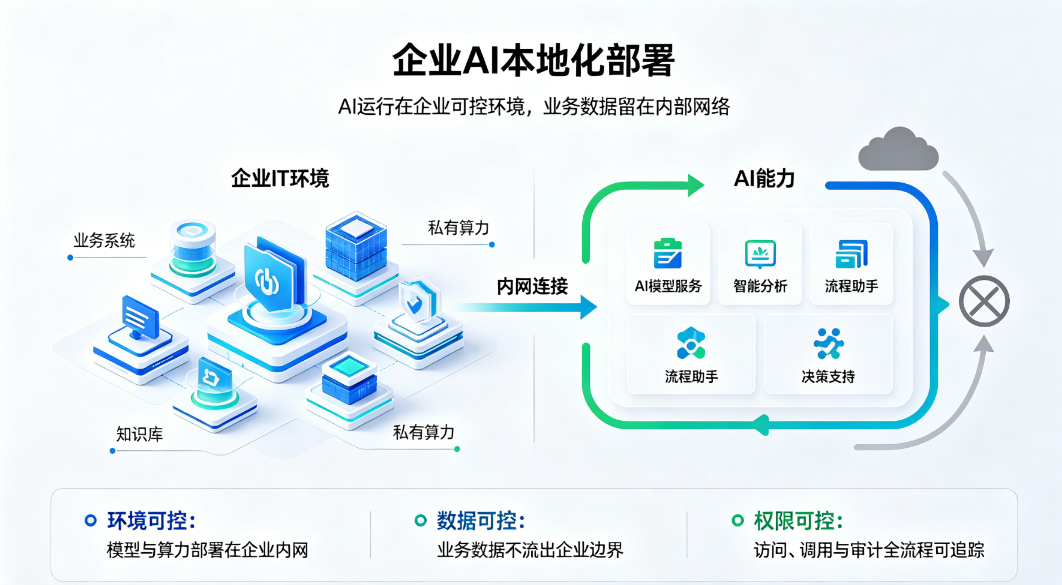
很多企业卡住的原因不是预算,是把这三件事混成了一件——一说「要本地化」,就默认「必须自己训一个大模型」,然后按自建大模型的规格去询价,看到报价就停了。真实情况是:这三件事各自独立,可以组合,也可以只做其中两件。
一、先分清三个「在哪」
问题 | 具体指什么 | 通常由谁决定 |
数据放在哪 | 业务数据存储在哪个环境 | 由合规与保密要求决定,多数情况下不可协商 |
模型跑在哪 | 推理算力部署在哪 | 由数据要求和成本共同决定,可以协商 |
产品放在哪 | AI 应用(界面、流程、系统集成)部署在哪 | 由部署方式决定,通常与数据同侧 |
三个问题里,只有第二个是「钱」的问题。第一和第三个是部署方式的问题,通常不构成额外的大额投入。
二、路径一:模型调用云端 API,产品部署在本地
做法:模型推理走云端大模型的 API;AI 产品(应用层)部署在企业自己的服务器上。
适合:数据敏感度中等——业务数据本身留在内网,交给模型的只是有限的、脱敏后的内容。
特点:不需要采购推理算力;模型可以随时替换,不被单一厂商绑定。
限制:如果合规要求是「数据一步都不能出内网」,这条路径不成立。
三、路径二:模型也在本地——开源模型私有化
做法:在企业自己的服务器上部署开源大模型,对内部提供标准 API;AI 产品同样部署在内网,通过 API 调用本地模型。
适合:数据一步不能出内网,或行业有明确保密要求的场景。
特点:数据全程不出内网;模型层与产品层解耦——算力按业务场景的规格配,而不是按「通用大模型」的规格配。
成本:需要采购带卡的服务器。这里要说明一句,模型开源不等于零成本,开源的是模型权重,不是承载它的机器。
四、路径三:混合——按场景分开
做法:对数据最敏感的场景(如财务、生产、涉密业务)走本地模型;对敏感度低的场景(如公开资料检索、通用问答)走云端 API。
适合:业务线多、数据敏感度不一的企业。
特点:把算力预算花在真正需要本地化的那部分场景上,通常能明显降低总投入。
前提:需要先做一份场景清单,把每个场景的数据敏感度标出来。
五、成本差在哪,以及最贵的那个错误
本地化路径的成本,主要落在一件事上:推理算力。
按能跑起来的最低配置,是一档;要留冗余、要支撑后续增加的场景,是另一档。这两档之间差别不小——但决定落在哪一档的,不是模型,是你打算让 AI 干哪些事。
所以这两年我们看到最贵的一个错误,是顺序反了:先买算力,再找场景。算力买了,场景没跑起来,追加预算;追加不上,项目就停了。正确顺序是反过来的:先定场景,再倒推算力,最后才决定硬件规格。
有一条判断标准,比价格更值得先问清楚:
你的数据,到底能不能出内网?
能出,省钱的办法很多。不能出,那就不是成本问题,是红线问题——这笔投入绕不过去。
六、常见问题
Q1 我们公司没有自己的大模型,能不能做企业AI落地?
能。企业AI落地不等于自建模型。产品层通过标准 API 接口对接大模型,模型是云端 API 还是本地部署的开源模型,都可以。
Q2 云服务器能满足私有化要求吗?
取决于「私有化」指的是哪一层。如果要求是业务数据留在企业环境,产品部署在自有服务器上通常够用;如果要求是数据一步都不出内网,算力需要落在企业自己的机房里。
Q3 开源模型可以商用吗?
多数主流开源模型采用允许商用的许可证,但不同模型的具体条款不同,选型时需要逐个确认。
Q4 本地化部署一定要买高端服务器吗?
不需要按「通用大模型」的规格配。要训练、要扛全量并发、要留大冗余,是一套配置;只做业务场景的推理,是另一套配置,两者量级不同。前提是先把场景定下来。
Q5 后期想换模型,需要重做吗?
产品层通过标准 API 接口对接模型,模型可替换。这正是「产品与模型解耦」的价值——不锁死在单一模型上。
Q6 企业AI落地最容易失败的环节是什么?
不是模型,是场景。模型选型几个月就能完成,让业务真正用起来通常需要更长时间。
七、安捷AI 在这件事里的位置
我们不做大模型,也不卖算力。我们做的是产品——把 AI 用进企业的业务流程里:让 AI 读你的单据、回答同事的问题、盯住异常、把散在各处的数据归到一起。
产品的 AI 能力通过标准 API 接口对接大模型。用哪家模型、模型放在哪里,由你决定,我们不做绑定。
因此在这件事上我们能保持中立:不靠模型赚钱,也不靠服务器赚钱。所以在「该不该上本地化部署」这个问题上,我们的建议不需要打折听。