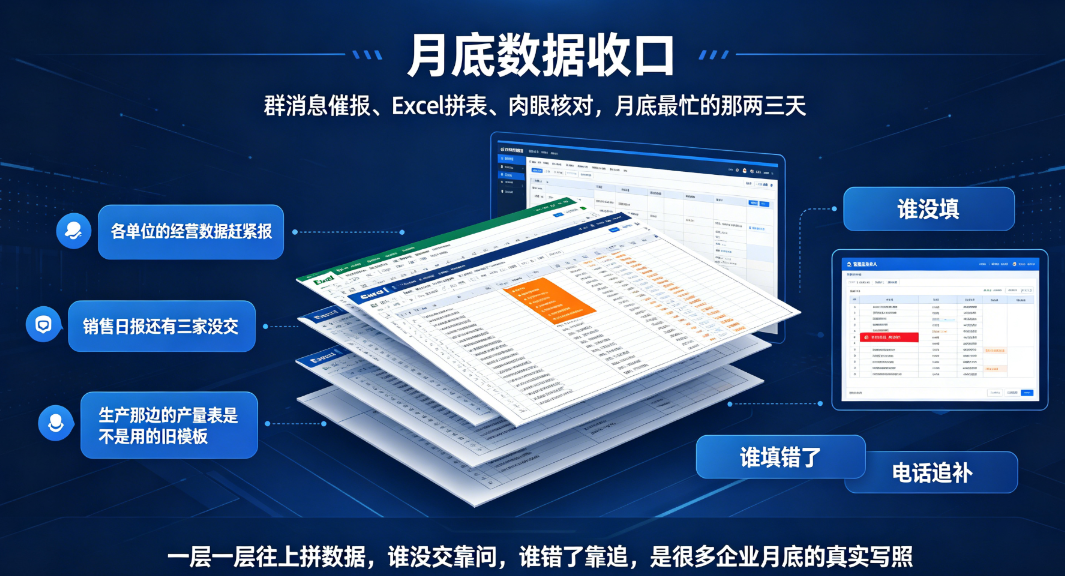
一、月底的崩溃瞬间:数据报上来,然后呢?
你可以想象这样一个画面:每个月临近月底的那两三天,财务或运营负责人的群里开始冒消息——"各单位的经营数据赶紧报""销售日报还有三家没交""生产那边的产量表是不是用的旧模板"。然后就是一层一层往上拼 Excel,谁没填靠肉眼数,谁填错了靠电话追。
这种事我在客户现场见过太多次,不是哪一家公司的毛病,是很多做实业、做连锁、做工程的企业都卡在同一个地方。大家默认数据上报就是"把数收上来",可收上来之后呢?很多公司的真实情况是:文件进了某个共享盘,或者堆在一个没人点开的文件夹里,下个月从头再来一遍。
口径又变了,上次报的数作废
更麻烦的是口径。这个月利润按"是否含运费"算,下个月忘了说,等到老板拿着两张表对不上,才发现两边定义根本不是一回事。要命的是,历史数据是按老口径存的,新口径一上来,过去半年的数没法直接比,等于白报。
数收齐了,却没法用来决策
我见过一家制造企业,每个月底能准时把十二家工厂的产量、良率、物料耗用收上来,表格做得漂漂亮亮。可老板真要拿它做下个月排产时,发现数据滞后了一周多,等看明白,市场已经变了。收齐和能用,中间还隔着一条很宽的河。
二、先掰扯清楚:AI数据上报到底是什么?
用AI把企业的经营数据——销售额、产量、回款、库存、项目进度——从分散在微信群、邮件、纸质单子里的人手里,高效地收上来,并且收上来之后真能用。它既不是给机器看的遥测,也不是给监管看的报送,而是给管理者自己看的经营底数。
三、一个判断:数据上报的终点,不该是一个没人看的文件夹
我越来越确信一句话:数据上报的终点,不该是一个没人看的文件夹。
收齐 ≠ 有用
很多企业把"报上来了"当成任务的终点,考核也只看准时率、完成率。可在老板眼里,准时收上来一堆对不齐、看不懂、滞后一周的数,和没报其实差不了多少。上报这件事真正的成本,不在填报那一刻,而在收完之后你还得花多少力气去清洗、对齐、解释。
真正值钱的是"收上来之后"
我常跟客户说,判断一套上报机制好不好,别看它收得多快,要看收完之后你能不能顺手做点什么:能不能直接追问"华东区回款为什么掉了",能不能在异常出现的当天推给责任人,能不能让历史数据和今天的口径对齐着看。能把"收"和"用"连起来,这件事才值得做;连不起来,它就是每个月准时发生一次的体力活。
四、过去为什么一直解决不了:结构问题不是工具问题
把锅甩给 Excel 或者微信群,其实冤枉了它们。问题出在结构,不在工具。
微信群 + Excel 的物理结构
微信群解决了"发出去"的问题,Excel 解决了"能算"的问题,可它俩拼在一起,天然缺少三样东西:谁该填、谁没填,系统不知道;同一个字段这家写"万"那家写"元",系统管不了;填完之后流到哪一步、谁看了、谁改了,系统留不下。这些缺口靠人肉补,补一次两次行,天天补就崩。
层层汇总的"传声筒"效应
一层一层往上收,每一层都在做搬运加整理。信息每过一道手,就可能被过滤、被修正、被延后。等到了顶层,你拿到的已经不是一线一开始的那笔数,而是经过好几双手"润色"过的版本。这不是哪个人不负责,是层层汇总的物理结构就自带损耗,和用不用好工具没关系。
不是工具不好,是结构扛不住
所以很多公司试过买更贵的报表软件,到头来还是回到微信群催、Excel 拼。不是软件不行,是它没有碰那个根本结构:发的人、填的人、用的人,这三方的动作和权责从来没被重新理过。下面这点,是这几年里真正在变的东西。
五、管理逻辑变了:发—填—用,三件事重新分工
过去这三件事是糊在一起的:财务既当发令员又当汇总工,一线既当填报人又当解释者。现在好的做法,是把"发、填、用"拆开,各自交给合适的环节。
发:谁来定口径、谁来发
口径这件小事,该由对数据定义负责的人一次性定死,而不是每个月靠群消息口头通知。谁有权改口径、改了之后历史数据怎么处理,得有地方记着。发不再是"催一下",而是把规则、模板、权限一次性布置下去。
填:怎么让填报人不痛苦
填报人真正抵触的是两件事:重复录和录了白录。如果 ERP 里明明有这个数,还要人再敲一遍,怨气就来了;如果填完没人看,下一次就更敷衍。好的填报设计,是能自动带出已知数、只让人补增量,并且让填报人知道"我填的这格是被谁看到的"。
用:数据落地的收尾一环
用,是过去常被忽略的一环。数收上来,得能立刻接住追问、能推异常、能进看板,而不是躺在某个导出文件里等人翻。
安捷AI数据填报就是按这个逻辑搭的,把"发—填—用"当作一条线而不是三个孤立动作来设计,高效解决企业经营数据上报问题
六、该不该上系统?先做哪个场景?三条判断标准
不是所有上报都值得上系统。我给老板们一个粗判法,三条标准,满足得越多,越该做。
判断标准 | 怎么问自己 | 上系统的信号 |
重复性 | 这件事是不是月月、周周都在发生,格式还差不多 | 高频重复、模板稳定,值得固化 |
跨度 | 要跨几级组织、跨几个互相不通的系统 | 跨三级以上或跨多个异构系统,人肉扛不住 |
用处 | 报上来之后,有没有人真拿它做决策或推动作 | 有"用"的落点,才不是纯体力活 |
判断标准一:这件事有没有"月月都要"的重复性
一天一次、一周一次、一月一次的报表,适合先动。偶发的一次性统计,用 Excel 凑合反而更灵活。判断该不该系统化的头一刀,就是看它是不是会反复出现。
判断标准二:跨几级、跨几个系统
一个门店报给总部,和十二家工厂、三家子公司、再加上一套金蝶、一套用友都报到一个池子里,难度完全不是一回事。跨的层级和系统越多,人肉汇总的损耗就越大,系统的价值就越明显。
判断标准三:报上来之后有没有"用"的地方
这一条才是根本。如果报上来只是为了交差、没人真看,那先别急着上系统,先把"用"的环节设计出来——哪怕先用看板把数亮出来,也比收完锁进文件夹强。
七、选型时容易被忽略的三件事
头一件容易被忽略的:权限与数据边界
谁看全部、谁只看自己那一摊,这件事上线前不划清,上线后就是麻烦。我见过销售数据让全员可见的,也见过门店店长能看到别家库存的。这事没标准答案,但必须在选型当天问清楚,别等数据跑起来再补。
第二件容易被忽略的:口径管理
前面说的口径变来变去,根子在没人管。选型时别只问"能不能做这张表",要问"口径改了,历史数据还能按老口径看吗"。这点问得越早,后面越少吵架。
第三件容易被忽略的:上报闭环
收上来不是结束。异常报了有没有人接、工单关没关、责任人改没改,这条线断在哪,数据就烂在哪。
安捷AI更看重把 ERP 里的已知数自动带出、减少重复录入,以及本地化部署下数据不出企业。
八、收尾:三条规矩
做了十几年企业数据服务,我把老板看待"AI 数据上报"这件事,归纳成三条自己守着的规矩:
规矩一:先问"收上来之后干嘛",再问"怎么收得快"
没有用处的上报,收得再快也是成本。先用处定下来,工具跟着用处走。
规矩二:口径必须有人管、有地方记
别让口径活在群消息里。谁能改、改了历史怎么算,写下来,系统帮你记。
规矩三:权限和闭环,上线前就定,别上线后补
谁看什么、异常报了谁接,这两件事拖到后面,补的成本比当初设计高得多。