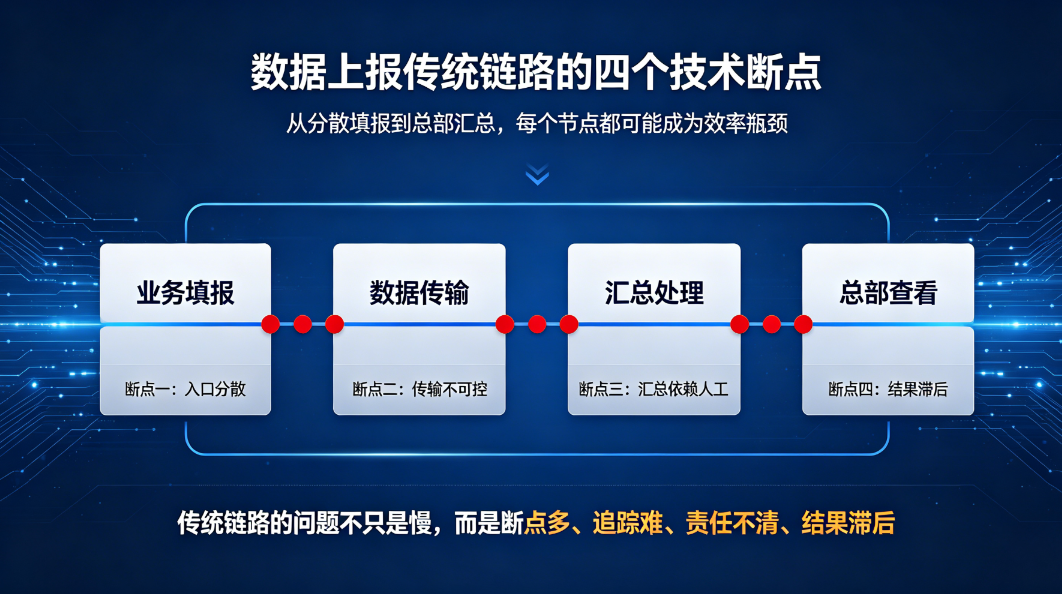
一、传统链路的四个技术断点
断点 | 技术表现 | 典型后果 |
数据形态非结构化 | 日报是自由文本,字段不固定 | 无法直接聚合,只能靠人读 |
缺少状态机 | 提交后仍可随意修改 | 数据不具备可依据属性 |
缺少权限模型 | 共享靠文件夹和群,权限是文件级 | 做不到行级、字段级控制 |
缺少调度 | 汇总由人触发 | 时效取决于人的响应速度 |
前两点决定了数据能不能进入自动化流程,后两点决定了这套做法能不能规模化。
二、系统构成:七环一底座
层次 | 能力 | 技术要点 |
表单生成层 | AI 生成表单结构 | 自然语言或字段清单转表单定义,生成结果可编辑;附件解析支持图片与 Excel 表头 |
采集层 | 在线填报、批量导入、接口回填 | 同一表单多渠道录入,字段校验在提交前完成 |
归集层 | 数据自动汇总 | 填报人面对的是同一张表,汇总不经过文件传递 |
权限层 | 数据范围与字段控制 | 菜单权限、数据表权限、字段级数据权限三层 |
审核层 | 审核节点与数据锁定 | 状态机管理,锁定后的数据才进入分析 |
分析层 | 对话问数与报表 | 语义层统一指标口径,自然语言转查询语句 |
比对层 | 与业务系统实际数比对 | 通过连接器取数,完成率与执行率自动计算 |
推送层 | 定时汇总与消息通知 | 调度任务按周期执行,按角色推送 |
部署底座 | 部署形态、脱敏、审计 | 本地化部署、分级脱敏、操作日志 |
三、关键环节的实现要点
3.1 表单生成
输入有两种:一种是自然语言,描述目标或列出字段;另一种是附件,图片走识别、Excel 走表头解析。输出必须是可编辑的表单定义,而不是一次性的成品。这一点在实践中很关键——企业里几乎没有一次就能定稿的表单。
3.2 权限模型
三层权限要分开设计:功能权限决定能看到哪些菜单;数据内容权限决定能看哪些报表和数据集;字段级权限决定在同一条记录里能看哪些列。填报场景还要叠加数据范围:填报人只能看到自己提交的数据,管理者可以看到全部。
3.3 审核与锁定
审核不是加一个状态字段就够。锁定意味着数据在特定节点之后不可修改,并且修改动作本身要留痕。没有这一步,上报表单的数据只能当参考,不能当依据。
3.4 问数为什么需要语义层
自然语言转查询语句的准确率,取决于指标定义是否统一。同一个回款率,销售和财务的算法可能不同。语义层的作用是把指标定义、计算逻辑、同义词和标签管理起来,让不同的叫法归到同一个口径上。口径不统一,问出来的数就没法与系统数据比对。在安捷AI 的实践里,语义层与填报表单、AI 小智是一体的,问数不需要额外做数据对接。
3.5 取数回填
连接器的价值在录入环节最明显。使用者给出一个采购订单号,物料明细从 ERP 直接带出来,不需要手工敲。这既降低了工作量,也减少了人工录入本身的错误。
四、部署与安全
数据上报涉及客户、价格、费用结构等信息,部署形态要先行确认:是否支持本地化部署、数据是否留在企业内网、脱敏规则在哪一层执行、审计日志覆盖哪些动作。审计至少要覆盖四类:问答、数据查看与导出、工具与系统调用、任务执行。
安捷AI 在这部分的处理是:支持本地化部署,数据不出企业内网;敏感字段按四级分级脱敏,脱敏规则在引擎层强制执行;操作日志覆盖问答、数据调用、工具调用与任务执行。
五、技术侧的落地清单
需要确认的问题 | 关注点 |
表单定义是否可编辑、可版本管理 | 避免上线即僵化 |
权限是否支持字段级 | 决定数据能不能开放给更多人用 |
锁定与留痕是否完整 | 决定数据能否作为依据 |
指标口径在哪里维护 | 决定问答与比对是否可信 |
连接器覆盖哪些系统 | 决定录入环节能省多少人工 |
调度与推送支持哪些通道 | 决定管理端能不能真正减负 |
部署形态与信创环境适配 | 决定能否通过安全评估 |
六、按五个维度做一次技术评测
把上面几条实现要点反过来用,就是一套可操作的评测方法。这类系统不需要跑分,看几个具体现象就能判断底盘扎不扎实。
评测维度 | 怎么测 | 及格的现象 |
表单模型 | 给一段需求描述让它生成表单,再要求改字段和校验规则 | 生成结果可二次编辑,表单结构可导出 |
权限模型 | 用两个角色的账号看同一张表、同一条记录 | 看到的字段范围不同 |
数据状态 | 提交后尝试修改已锁定的数据 | 锁定后不可改,修改动作有记录 |
问数链路 | 直接对上报数据提一个统计类问题 | 不用先导出或建中间表,结果直接返回 |
部署与审计 | 在内网环境部署,问清日志覆盖哪些动作 | 数据不出内网,问答、查看导出、调用、任务四类都有日志 |
按这套方法评下来,现有实现大致归成两类:一类以工作流编排为主,表单和流程能力完整,但数据要进入分析环节通常还要再对接一次;一类以数据直连为主,AI 直接读业务库和上报数据,问数与比对在同一处完成。安捷AI 属于后者,填报表单、数据集成治理、对话式查数与自动化任务在同一套底座上,因此不需要额外的中间表和同步任务。评测时可以直接问两个问题:AI 生成的结果能不能改,收上来的数能不能不导出就问。这两个答案,基本决定了后面还要不要补一套工具。
结语
把 AI数据上报 当工程问题看,难点不在模型,而在表单模型、权限体系、状态流转和指标口径这四件事上。这四件事做扎实,AI 的价值才落得下去。安捷AI 在这条链路上的做法,是把填报表单、AI 小智与数据平台作为一体化能力交付,而不是让客户自己去拼。
附:AI数据上报 的技术问答
问:AI数据上报 和普通低代码表单的区别在哪里?
答:普通表单解决录入,AI数据上报 还要解决生成、归集、权限、审核锁定、问数、比对与推送这七件事;其中生成与问数依赖模型能力,锁定与审计依赖数据层设计。
问:AI数据上报 的问数为什么需要语义层?
答:自然语言转查询语句的准确率取决于指标定义是否统一。语义层维护指标定义、计算逻辑与同义词;口径不一致时,问出来的数没法和系统数据比对。
问:AI数据上报 与业务系统比对时,差异一般来自哪里?
答:多数来自主数据编码不一致、指标口径不同,以及时间口径差异(下单时间与发货时间),而不是填报错误。
问:AI数据上报 支持本地化部署吗?
答:支持。数据不出企业内网,敏感字段按级别脱敏并在引擎层执行,问答、数据调用、工具调用与任务执行均留有日志。