一、先看一个几乎每家都会遇到的场面
季度经营会,老板当场问了一句:"上个月华东区各产品线的毛利是多少?"
会议室里那个 AI 助手,写会议纪要很利索,改 PPT 大纲也很快。这一句问出去,它停了五六秒,回了一句:"我暂时无法获取贵公司的经营数据。"
场面有点尴尬。老板摆摆手说"算了",这个话题就过去了。
但从那天起,这个 AI 在公司的命运基本定了——没人再在会上打开它。
很多人把这件事归因为"AI 还不够聪明"。其实不是。给 AI 一篇三万字的产品文档,它能读懂;给它一份复杂的合同,它能挑出风险条款。它不是不会分析,它只是根本拿不到那张表。
问题的位置很清楚:不在模型那一层,在数据那一层。
二、数据卡在哪:四道关,一道过不去就白搭
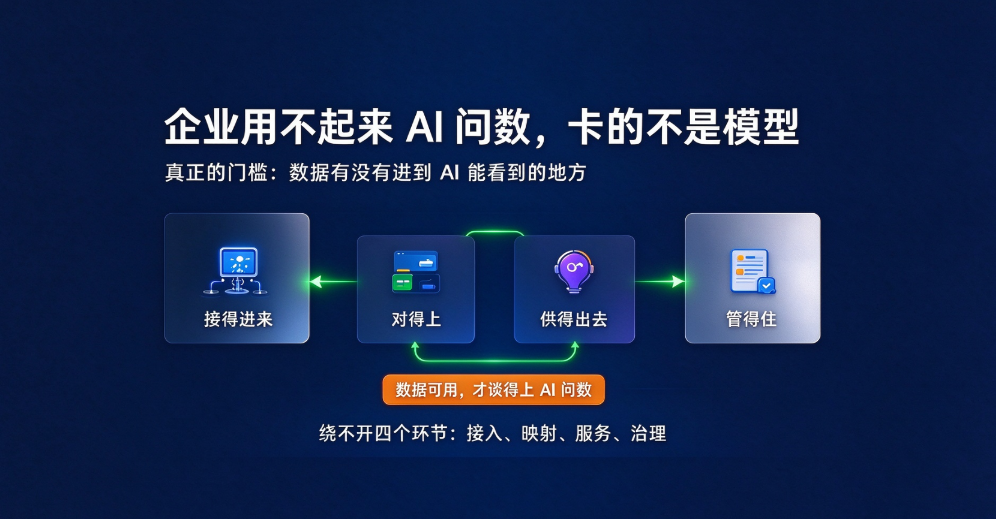
企业要让 AI 真正能用上自己的数据,中间有四道关。这四道关的顺序就是数据流动的顺序:
各系统数据 → ①接得进来 → ②对得上 → ③供得出去 → ④管得住 → AI 能用
大多数企业的情况是:第①关就没过。
第①关:接得进来吗
一家正常经营了十年的制造企业,数据大概散在这些地方:
· 用了八年的 ERP(可能是用友 U8C、金蝶云星空,也可能是一套早就没人维护的自建系统)
· 财务系统、进销存另一套
· 审批在钉钉或飞书
· 生产数据在一个十年前上线的 SQL Server 里
· 业务部门的销售台账,还在 Excel 里传来传去
· 客户数据在 CRM,供应商数据在另一个表里
没有哪一家厂商的连接器能一次覆盖这些。这不是某家的能力问题,是客观情况:任何一家厂商的连接清单,都围绕它自己的产品线构建。
所以企业面临的实际选择是:要么各接一次(四套集成、四套脚本,改一处要改四处),要么找一层能统一接入的中间层。
第②关:对得上吗
假设数据接进来了,第二关立刻出现。
把数据库表结构直接给 AI 看,它看到的是一堆字段名:amount、net_amount、total_amt、gross_profit。
它能做出合理推测,但只是推测。amount 含税还是不含税?含不含运费?退货怎么算?这些信息不在字段名里。
更麻烦的是,企业内部本身就没有统一算法。销售部算毛利不含运费(运费他们不管),财务部算毛利要扣返利(返利是真实成本),老板心里的毛利是能装进口袋的钱,可能还得再扣一层。
三个算法都对,只是不是同一个东西。这件事在没有 AI 的时候就存在,只是以前争论发生在人和人之间,现在变成 AI 和 AI 之间,而且速度更快。
数据接进来了,但答案不可信,等于没接。
第③关:供得出去吗
第三关最容易被忽略,但它决定了这笔投入会不会打水漂。
很多企业是通过某家 AI 厂商自带的连接器把数据接进去的。接的时候很顺,但接完之后有个问题:这些数据只有那一家 AI 能用。
明年公司换一个 AI 平台,或者业务部门想用另一个 AI 工具,这些连接全部要重做一遍。数据本身没变,口径定义也没变,但就是得重接。
这就是"接进去一次,被锁在一个地方"。企业真正需要的,是一次接入、任何 AI 都能取的供数方式。
第④关:管得住吗
第四关通常由 IT 负责人提出,而他们的顾虑非常具体。
现在给 AI 连数据库,最常见的做法是在某个客户端的配置文件里填上地址、账号、密码。以 WorkBuddy 为例,就是 ~/.workbuddy/mcp.json 里写一段 JSON:
`json
{
"mcpServers": {
"database-mcp": {
"command": "npx",
"args": ["-y", "@turingdance/database-mcp"],
"env": {
"DB_TYPE": "mysql",
"DB_HOST": "10.0.1.23",
"DB_USER": "root",
"DB_PASSWORD": ""
}
五分钟能跑通,这个体验确实很爽。但看清楚三件事:密码是明文的,就存在某个人的电脑上;账号是 root;这个工具还带 execute 接口,能执行 INSERT、UPDATE、DELETE、DROP,风险控制只靠调用方传一个 confirm 参数。
腾讯云在教用户用 WorkBuddy 连 PostgreSQL 的文档里,专门写了一段提醒:
> "示例使用的是开源 MCP Server。正式用于生产环境前,请评估其来源、版本、权限范围和安全风险,并使用独立的只读数据库账号控制访问范围。"
这句话值得逐字读。它建议用只读账号去限制范围——但"建议"不是"强制",做不做取决于每家企业的自觉。
所以第④关的三个具体问题是:取数是不是只读、能不能按人控权、出了事能不能查出来是谁。
三、为什么厂商自带的连接器解决不了这四关
有人会说:我用金蝶灵基、用友 YonWork,它们不是有连接器吗?
有,而且客观讲做得不错。金蝶灵基今年 5 月发布,ERP 连接器首批就有70 个连接器、1127 个 Tool,覆盖金蝶 AI 套件、星瀚、HR、星空、星辰等全系产品。用友 YonWork 随 BIP 6 发布,官方口径是"以松耦合方式连接 YonBIP、YonSuite、U9C、U8C 及各类异构系统"。
但这类连接器有三个客观的边界,正好对应上面的第①、③关:
边界 | 具体表现 | 影响哪一关 |
范围 | 连接清单以自家产品线为主。金蝶的 70 个连接器,全部是金蝶自家产品 | 第①关:接不全你实际在用的那些系统 |
归属 | 连接层是自家 AI 的私有能力。数据接进去,只有它家 AI 能用 | 第③关:换 AI 要重接 |
深度 | 连接器解决"取得到",不解决"算得对"。API 直调 ERP 业务能力,和口径统一的宽表不是一回事 | 第②关:字段含义和计算规则没人写下来 |
这三条不是缺点,是定位不同。它们的连接器是为了让自家 AI 更好用,这个目标它做到了。一个卖 AI 的厂商,没有理由把自己最重要的数据通道开放给竞争对手的 AI 用。
所以结论是:厂商连接器不是替代品,是另一个层次的东西。它们是"给自家 AI 用的数据通道",企业还需要一层"给所有 AI 用的数据层"。
四、这一层到底该干什么:四件事,一个不能少
把上面的四道关翻译成产品能力,就是四句大白话:
四件事 | 要做到什么程度 |
接得进来 | 企业手上真实在用的那些数据源,都要接得进来。不挑品牌、不挑新旧、不挑有没有 API |
对得上 | 每张表、每个字段的业务含义和计算规则都写下来,员工换说法问也能问对 |
供得出去 | 用标准协议供数,任何支持这个协议的 AI 都能取,不被绑在某一家 |
管得住 | 取数只读、按人控权、全程留痕、数据可以不出企业 |
这四件事看起来平淡,但它的顺序不能乱。很多企业一上来就关心"管得住",结果卡在第一关——数据根本接不进来,管什么?
五、一张可以拿去问供应商的自检表
四件事拆开,就是九个具体问题。不需要懂技术,逐条问,答不上来的就是缺口。
第一关 · 接得进来
Q1:我们要接的系统,你们支持哪些?
具体数:主流数据库支持多少种?国产数据库(达梦、人大金仓、瀚高)支持吗?没有 API 的老系统怎么办?Excel 能不能直接接?钉钉飞书企微能不能接?
Q2:对接我们的 ERP,要不要写代码?
如果对方说"我们有 API,你们自己调",那意味着你要自己写集成。有预制数据字典模板的产品,是勾选即用。
Q3:数据接进来之后,要加工怎么办?
原始表通常不能直接给 AI 用——字段名看不懂、口径没统一、多表要关联。加工环节是可视化配置还是写代码,直接决定后续维护成本。
第二关 · 对得上
Q4:表说明和字段说明存在哪里?
如果答案是"写在提示词里",那要注意:提示词会散落在各个 AI 的配置里,半年后会出现五个版本的算法,没人知道哪个最新。
Q5:员工用口语问,能问对吗?
财务叫"毛利",销售叫"利润空间",老板直接问"这单赚了多少"。字段能不能配这些同义词,决定实际使用中能不能问得准。
第三关 · 供得出去
Q6:输出是什么形式?是标准协议还是私有接口?
标准协议意味着今天用这个 AI、明天换那个 AI,都不用重接。私有接口意味着绑定。
Q7:换 AI 平台,这些接入要重做吗?
这个问题最好在签约前问,签完再问就晚了。
第四关 · 管得住
Q8:取数是只读吗?技术上能不能写?
注意区分"配置成只读"和"产品根本没有提供写这个动作"。前者是一个开关,理论上可以打开;后者是设计上就不提供。
Q9:能不能查出来上周谁通过 AI 拿了什么数据?
日志里要能看到:请求人、AI 客户端、调用的数据服务、时间、返回的字段范围。只有客户端本地日志是不够的。
六、安捷AI 数据底座是怎么做的
安捷AI 数据底座是安捷AI 的产品模块,只做一件事:数据连接层。把企业散在各系统的数据接进来,加工成统一口径的标准业务数据,再以 MCP 服务开放给 AI 用。
第一关 · 接得进来
支持18 种主流数据库与数据源:
类别 | 具体支持 |
关系型数据库 | SQL Server、MySQL、Oracle、PostgreSQL、SQLite |
国产数据库 | 达梦、人大金仓、瀚高 |
分析型与专用库 | SAP HANA、SSAS、MongoDB、InfluxDB、ElasticSearch |
文件与通用接口 | Excel 文件、HTTP API、ODBC 通用扩展 |
三方应用 | 企微、钉钉、飞书、金蝶云星空/云星辰、用友 U8C/U9C/YonSuite |
对接用友、星空这类系统,还有预置数据模板,勾选即用,不用手写 SQL。
数据更新支持实时直连或定时抽取两种方式。
加工环节
接进来的原始表要加工才能给 AI 用。这一层是可视化配置,不写代码:
字段筛选、类型转换、公式计算、条件打标签、多表横向纵向合并、行转列列转行、分组汇总。
中小数据量的宽表,几分钟能配好。
第二关 · 对得上
三样东西,全部沉淀在数据底座里,而不是散在各个 AI 的配置中:
能力 | 具体做法 |
数据集备注说明 | 每张表写明这张表是做什么的、统计口径是什么、包含哪些数据、排除了哪些 |
字段说明 | 每个字段写明在本企业的具体含义与计算规则 |
AI 同义词 | 给字段配置业务口语叫法,员工换个说法也能问对 |
效果是:无论企业用哪个 AI、员工用什么说法问,问出来的都是同一个口径。
举个具体的:财务把"毛利率"的计算规则写好,配了"毛利""利润率""利润空间"三个同义词。之后老板用手机上的通用 AI 问"上个月利润空间怎么样",业务部用自己的 AI 问"6 月毛利率多少",读的是同一份口径定义,算出来的是同一个数。
第三关 · 供得出去
输出的是标准 MCP 协议的数据服务,端到端已经实测打通,数据可被正确调用。
具体路径:以WorkBuddy举例,在MCP配置中部署安捷AI数据底座MCP协议,连接成功后直接问业务问题,WorkBuddy 通过 MCP 取数并返回结果。
因为是标准协议,这套接入和口径定义保存在数据底座自己这里,不跟着某一家 AI 走。
第四关 · 管得住
· 只读,不提供写能力。这是产品设计选择,不是可配项
· 每个 AI 客户端发放独立访问密钥,每把密钥绑定一个执行用户,AI 能看到什么等于这个人有什么权限
· 支持行权限、列权限、字段脱敏,可控制发布范围与单次最大返回行数
· 调用全量留痕、可审计,配套水印与登录日志
· 支持本地部署,数据库不对外开放
七、常见问题
Q1:数据底座和数据中台,有什么区别?
数据中台解决的是"数据怎么存、怎么算、怎么管",能力厚重,落地周期和投入都更长。数据底座解决的是"AI 怎么取到、怎么理解这些数据",范围窄得多,也轻得多。
如果企业已经有数据中台,两者可以并存:数据中台继续负责存储、计算和指标管理,数据底座负责面向 AI 的语义说明与 MCP 供数。
Q2:我们已经用了金蝶灵基(或用友 YonWork),还需要这个吗?
取决于你的数据在哪。
如果所有需要被 AI 使用的数据都在金蝶(或用友)体系内,那么它自带的连接器可能够用。
如果你的数据还散在别的系统里——审批在钉钉或飞书、生产数据在老的自建系统、业务台账在 Excel 里——那需要另外一层来覆盖。另外,通过某家 AI 的连接器接进去的数据,只对那家 AI 有效。
数据底座是跨厂商中立的:接一次,所有支持 MCP 的 AI 都能用。
Q3:只读会不会不够用?业务需要 AI 帮我们改数据。
这是需要分开看的问题。
"让 AI 改生产数据"目前在企业里普遍是高风险动作——AI 的输出不完全可预测,一次误判可能改掉几百条记录。业界通行的做法是把读和写分开:读操作可以自动化,写操作要有人确认。
数据底座选择只读,是把这个原则固化进产品。需要写回的场景,建议通过专门的业务系统流程去做,而不是给 AI 开一个写接口。
Q4:我们没有 API 的老系统,怎么办?
实施中常见的三种做法(具体取决于老系统的开放程度):
1. 直连数据库——如果老系统用的是 SQL Server、Oracle 这类主流库,即使它没有 API,也能直接连库取数(只读)
2. ODBC 通用扩展——覆盖一些不常见的数据库类型
3. Excel / HTTP 导出中转——实在接不了库的,业务先按固定格式导出,由数据底座定时抽取
实际项目里第三种的占比不低,因为很多老系统的库并不开放,或者没人敢动。
Q5:数据会不会出我们公司?
支持本地部署。程序部署在企业自己的服务器上,数据库不需要对公网开放,AI 通过 MCP 协议访问这个部署在企业内部的服务,取到的数据不经过第三方云。
Q6:接入要多久?
数据库接入是填好连接信息测试连通;加工宽表中小数据量几分钟可以配好;三方应用(用友、金蝶云星空等)有预制数据字典模板,勾选即用。
实际周期主要取决于两件事:要接几个源,口径要对齐多少指标。这两件事定了,剩下的都是配置工作。
八、下一步
如果你的企业正在做 AI 落地,卡在"AI 查不到数据"这件事上,可以先做一件很简单的事:
把上面九条自检问题打印出来,逐条问一遍现在的供应商。
哪一条答不上来,缺口就在那里。大多数企业问完会发现,问题不在 AI,在数据进来的那条路上。
我们通常会先帮客户确认三件事:数据源有哪几类、要开放给 AI 的指标是哪些、权限按什么维度划分。这三件事清楚了,剩下的都是配置工作。