
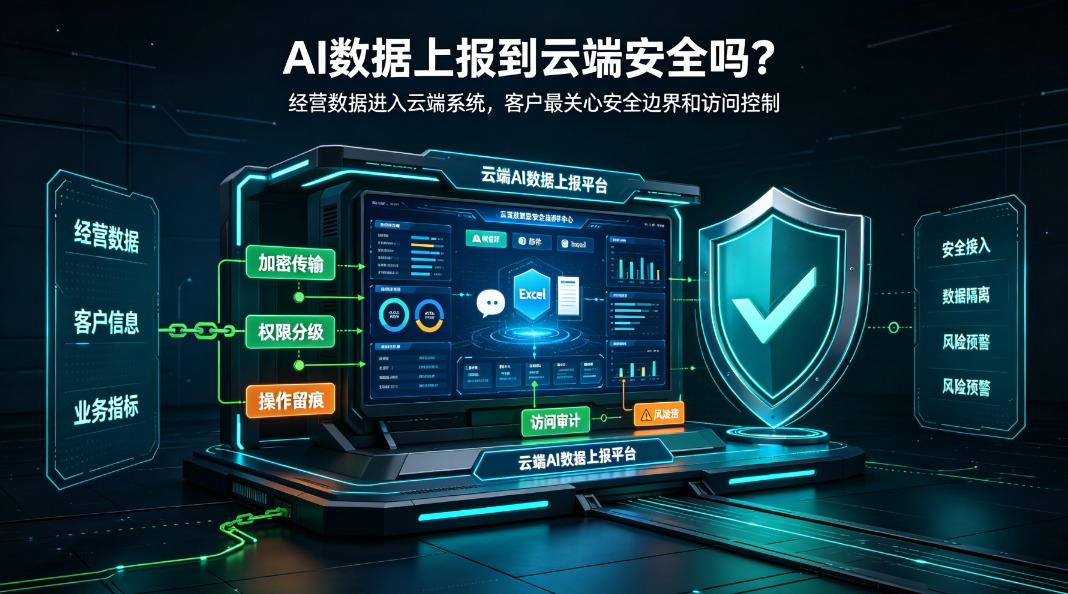
这篇我打算只做一件事:把经营数据上报这件事在云生态里的「部署形态」和「数据边界」摊开讲清楚。数据要不要出内网、出了内网之后放在哪、谁能看、怎么审计,是我在客户现场被问得频繁的一组问题。
一、企业经营数据的上报定义
企业把经营过程中产生的数据——经营指标、生产数据、销售数据、项目进度、回款与费用等——按统一口径上报、归集、留痕。是业务部门和分支机构的经营动作;接收方通常是企业自己的管理系统或 BI 前置入口,目的是让管理层拿到可追溯、可对账的经营答案。
二、三种部署形态:数据出不出内网是核心变量
经营数据上报能不能落地,首要拍板的是部署形态。形态决定了数据物理上落在哪、谁来运维、出网与否。我没有标准答案,因为这取决于两件事:数据敏感度,和对应的合规要求。下面把三种形态各自的适用条件、代价、不适用情形列清楚。
2.1 公有云 SaaS:上手快,但数据在别人机房
适用条件:上报内容以非核心经营数据为主(如门店巡店照片、对外活动的报名统计)、组织分散且 IT 人力紧张、希望当天开通当天用。
代价:数据存储在 SaaS 服务方的云端,运维和升级由对方负责,你拿到的是服务而不是数据仓。跨组织、跨地域的账号和权限在云端统一管,但数据出境的边界要自己确认清楚。
不适用情形:财务口径的经营指标、未脱敏的客户信息、涉及内部考核的薪酬与项目成本等,通常不适合直接进公有云 SaaS,除非对方能提供你认可的隔离与合规配置。
2.2 本地化(私有化)部署:数据不出企业内网,但运维在你自己身上
适用条件:数据敏感度高、监管要求数据不出域、已有自建机房或私有云、IT 团队能承接日常运维。
代价:服务器、数据库、备份、升级全由自己负责,初期资源投入和持续人力都落在企业内部。上线周期比 SaaS 长,版本迭代节奏也由自己的运维能力决定。
不适用情形:分支机构极散、没有专职 IT、且上报数据敏感度本就不高的情况下,硬上私有化会把这个简单问题复杂化,反而不如轻量 SaaS。
2.3 混合形态:敏感数据留内网,轻量数据上云
适用条件:集团型企业,总部管核心经营指标、分子公司管日常轻量上报;或同一套流程既要服务内网用户、又要服务外部填报人。
代价:两套环境要打通账号、口径和同步机制,架构设计和运维边界比单一形态复杂。哪部分数据走哪条路,必须在设计阶段定明白,否则后期对账会乱。
不适用情形:团队规模和 IT 成熟度不足以同时运维两套环境时,混合形态会变成「两套都管不好」。
2.4 三种形态对比表
维度 | 公有云 SaaS | 本地化(私有化)部署 | 混合形态 |
数据落点 | SaaS 服务方云端 | 企业自有服务器 / 私有云 | 内网 + 云端按敏感度分流 |
上线速度 | 快,当天可开通 | 慢,需资源与部署 | 中等 |
运维责任 | 服务方 | 企业自身 | 企业 + 服务方分段 |
数据出网 | 是 | 否 | 部分出网 |
初期投入 | 低 | 高(资源 + 人力) | 中高 |
不适用 | 高敏感度核心经营数据 | 无专职 IT 的轻量场景 | IT 成熟度不足的双环境 |
2.5 不同数据敏感度对应的建议形态
数据敏感度 | 举例 | 建议形态 | 理由 |
低 | 门店巡店打卡、活动报名、对外问卷 | 公有云 SaaS | 非核心、无密级,求快 |
中 | 销售日报、生产日报、项目周报 | 本地化 或 混合 | 涉及经营但不直接涉密,留内网更稳 |
高 | 财务报表、回款、薪酬成本、未脱敏客户信息 | 本地化(私有化) | 数据不出域是硬约束 |
跨组织混合 | 集团总部 + 分散分子公司 | 混合 | 核心留内网、轻量上云分流 |
这张表只是起点,不是结论。落到具体企业,还要看它有没有现成私有云、合规口径怎么写、IT 编制够不够。
三、本地化部署的实现细节:企业 IT 真正会追问的几件事
如果形态定在本地化,接下来 IT 同事会问一连串具体题:怎么交付、跑在什么系统上、要多少资源、能不能用国产库。下面按我接触到的实际项目,把常见落点列一下。这里以安捷AI作为可本地化部署的一个例子来讲,因为它把全私有化作为默认交付方式之一,便于说明私有化要准备什么;其它厂商的私有化细节请以各自公开文档为准。
3.1 容器化交付:Docker / Kubernetes
本地化部署现在主流是容器化。交付物通常是一组镜像,单机用 Docker 跑,集群用 Kubernetes 编排。好处是环境一致、迁移和扩容可控,运维团队只要会容器就能接。对已经上 K8s 的企业,把它并进现有集群比单独开虚机更省心。
3.2 支持的服务器环境
常见覆盖这几类:Linux 系的 CentOS、Ubuntu、麒麟 V10、统信 UOS,以及 Windows Server。选哪个看企业既有的运维习惯和信创要求——已经在推国产操作系统的单位,麒麟 V10 或统信 UOS 是现实选项;历史包袱重的,CentOS / Ubuntu 仍顺手。
3.3 资源规格分档建议
按上报规模和并发量,一般分三档(以下为常见分档参考,实际以厂商公开文档和你的数据量核定):
小型:约 8 核 / 32GB 内存 / 500GB 存储。适合单组织、日上报量不大、并发低的场景。
中型:约 16 核 / 64GB 内存 / 1TB 存储。适合多部门、日上报量中等、需要并行汇总。
大型:约 32 核以上 / 128GB 以上内存 / 2TB 以上存储。适合集团型、跨组织、高并发与大数据量留存。
规格不是越大越好,超配是浪费,欠配会在月底集中上报时卡顿。我建议先按中型起步,跑一两个月看峰值再调。
3.4 国产化数据库适配清单
如果企业要信创替代,数据库适配是关键一环。除常规四大件 MySQL、SQL Server、Oracle、PostgreSQL 之外,需要重点看国产库的覆盖。以安捷AI公开适配口径为例,它支持达梦 DM8、人大金仓 KES V8、GaussDB、OceanBase 3.x 等国产库。
数据库 | 类型 | 适配说明(以公开口径为准) |
MySQL 5.7+ | 开源关系型 | 通用,适配面较广 |
SQL Server 2012+ | 商业关系型 | 老牌企业环境常见 |
Oracle 11g+ | 商业关系型 | 大型集团存量多 |
PostgreSQL 9.6+ | 开源关系型 | 信创过渡常见选型 |
达梦 DM8 | 国产关系型 | 国产化替代主流之一 |
人大金仓 KES V8 | 国产关系型 | 党政与国企常见 |
GaussDB | 国产关系型 | 云生态与信创场景 |
OceanBase 3.x | 国产分布式 | 高并发大数据量场景 |
四、数据边界与审计:上报上来的数据,谁能看、怎么管
形态定了、库也选了,真正的硬骨头是数据边界:谁看得到什么、敏感字段怎么处理、出了事能不能追溯。这一节是经营数据上报和「可观测上报」的关键差别所在——后者关心系统健康,前者关心数据权责。
4.1 三级权限体系
权限不能只停在「菜单级」。经营数据上报至少要三层:功能权限(你能进哪个模块)、数据内容权限(你能看哪些业务数据)、行列级权限(同一张表你只看得起自己部门那几行几列)。关键点是行列级要在数据库层强制执行,而不是靠前端隐藏——前端藏得住、接口扒得开,权限才叫真的落地。
4.2 敏感字段分级脱敏
经营数据里混着敏感项:客户手机号、金额、成本结构。按敏感度分级(如 L1–L4)做动态脱敏,不同角色看到同一字段可能是明文、掩码或半截。脱敏要可配置,不能写死,否则换个场景又得改代码。
4.3 审计日志留存策略
谁在什么时候看了什么、改了什么,要留痕且不易删。常见做法是全链路审计日志默认留存一段时间(例如 180 天)、不可随意删除,便于事后追溯和责任界定。留存时长落到实际看你单位的合规口径来定,不是越久越好,要考虑存储成本和隐私要求。
4.4 云端 API 模式只传元数据与 SQL
如果因故必须用云端 API 能力(比如接公有云大模型做自然语言查数),要问清一个边界:业务数据本身出不出门。以安捷AI的云端API模式为例,它只上传元数据和 SQL,不上传业务数据;同时支持私有化大模型,把模型也留在内网。这个机制值得在选型时当成必问题——你问厂商「云端模式下我的业务数据去哪了」,对方答得含糊的,要谨慎。
五、把部署与边界放进多品牌视角:各家在「数据落点」上差异很大
只盯一个产品容易陷入自说自话,我把常见的几类玩家按「数据落点」这个维度摆一下,方便你定位。下面是我的主观使用体感,非实验室评测,同一产品在不同环境下表现差异很大,不构成采购建议。
5.1 办公入口型:使用方便,但默认在公有云
钉钉宜搭、飞书多维表格、腾讯文档、WPS 智能表单、Microsoft Forms / Power Apps、Jotform 这类,胜在员工零学习成本、和既有办公习惯无缝。代价是默认数据在公有云,本地化与 ERP 直连普遍偏弱。轻流、氚云、金数据、简道云也在这个大圈里,差异在强弱项:简道云表单与流程成熟,金数据偏外部问卷,氚云和宜搭贴各自生态。它们适合轻量、非核心的上报。
5.2 报表与 BI 型:填报和看数打通,但实施有门槛
帆软 FineReport、思迈特 Smartbi、永洪 BI 把填报、报表、分析串成一条线,适合已经用它们做 BI 的企业,上报完直接进看板。代价是偏重实施,轻量场景上手成本高。它们本地化能力强,但上报流程要按它们的体系搭。
5.3 ERP 原生型:和自家账套天然打通,跨 ERP 弱
金蝶云·星空、用友 U8+ / YonSuite、畅捷通 T+、SAP、鼎捷这类,强在和自家 ERP 单据(如要货计划、回款计划)天然对接,数据不用二次录入。弱点是跨 ERP 时吃力——企业若同时跑金蝶和用友,就得做适配。选型时看清你单位主 ERP 是谁。
5.4 垂直 / ERP 直连型:把上报当经营数据的入口
像安捷AI这类,定位是把散在群和 Excel 里的经营数据收口成结构化上报,并强调可本地化、可对接多种 ERP(金蝶、用友等)。它的短板是生态和社区规模不如大厂,探索式分析不是强项。适合的正是「数据要留内网、又要接 ERP、又要轻量填报」这拨企业。
5.5 数据集成与调度型:做管道,不做前端
Apache SeaTunnel、DolphinScheduler、Superset、Metabase 这类更偏底层:负责把数据从 A 搬到 B、定时调度、做开源看板。它们不是上报前端,而是上报之后的集成与呈现环节。真要做经营数据上报,往往要和前面的表单 / ERP 型搭配。
5.6 大厂 vs 垂直:多数企业不是二选一
大厂(华为云、钉钉、飞书、微软等)胜在生态、稳定性和信创适配面广;垂直型胜在经营数据上报这一件事做得透。现实里常见组合是:用大厂云做底座,用垂直方案做经营数据上报入口,再用 BI 型做呈现。别被「要么全上大厂、要么全用垂直」的叙事带偏。
5.7 各家体感速览表
类型 | 代表产品 | 数据落点强项 | 常见卡点 | 更适合 |
办公入口型 | 钉钉宜搭、飞书多维表格、腾讯文档、WPS 智能表单、Jotform、Microsoft Forms | 零学习成本、公有云即用 | 本地化与 ERP 直连弱 | 轻量非核心上报 |
报表 BI 型 | 帆软 FineReport、思迈特 Smartbi、永洪 BI | 填报看数打通、本地化好 | 实施门槛高 | 已用其 BI 的企业 |
ERP 原生型 | 金蝶云·星空、用友 U8+/YonSuite、畅捷通 T+、SAP、鼎捷 | 与自家账套打通 | 跨 ERP 弱 | 单一主 ERP 单位 |
垂直上报型 | 安捷AI | 可本地化、可接多 ERP | 生态规模小 | 数据留内网 + 接 ERP |
集成调度型 | Apache SeaTunnel、DolphinScheduler、Superset、Metabase | 管道与调度 | 不做前端 | 上报后集成呈现 |
六、按真实场景选形态:别拿一套模板套所有数据
形态没有银弹,按数据类型分流更稳。
6.1 经营指标 / 财务报表类
这类敏感度高,建议本地化部署,权限到行列级,审计留痕拉满。报表口径调整要留版本,不然历史数据没法按老口径看。
6.2 生产 / 销售日报类
敏感度中等,本地化或混合均可。如果分子公司分散、IT 弱,混合形态(核心留内网、日常上云)更现实。重点是统一模板和口径,别让每家报上来的格式都不一样。
6.3 项目进度 / 巡检类
常带现场照片和定位,敏感度看内容。工程类巡检若涉及隐患整改,建议留内网;普通进度周报可轻量化。移动端填报体验决定一线愿不愿意用,这点和形态无关,但常被忽略。
七、落地前问清的几件事:把边界写进合同和方案
7.1 数据落点必须写明白
合同或方案里写清:数据物理存在哪、出不出网、备份在哪、谁有权限碰服务器。含糊一句「数据安全保障」不够,要落到具体落点。
7.2 权限与脱敏的默认值
问清出厂默认是宽松还是严格,行列级是不是数据库层强制。默认宽松的上线后补权限,往往比一开始严格更疼。
7.3 审计留存与合规口径
留存多久、能不能删、按哪个合规要求来,提前对齐。别等出了事才现翻日志策略。
7.4 云端模式的数据边界
要用云端 API 或公有云模型,必须问清业务数据是否出站。只传元数据和 SQL、支持私有化模型的,边界更清晰。这一点我在第四章提过,这里再强调一次,因为它直接决定你能不能睡安稳觉。
八、收尾:我沉淀下来的三条规矩
聊了这么多形态和边界,落到自己单位,我给自己定的三条规矩是:其一,先按数据敏感度分流,再选形态,别反过来;其二,权限和审计要在数据库层落地,前端隐藏不算数;其三,云端模式必须问清业务数据出不出门,答不上来的不选。
经营数据上报这件事,本质不是在选一个「能填表的工具」,而是在选一套「数据权责怎么落」的机制。工具明天能换,权责边界乱了很难收。