
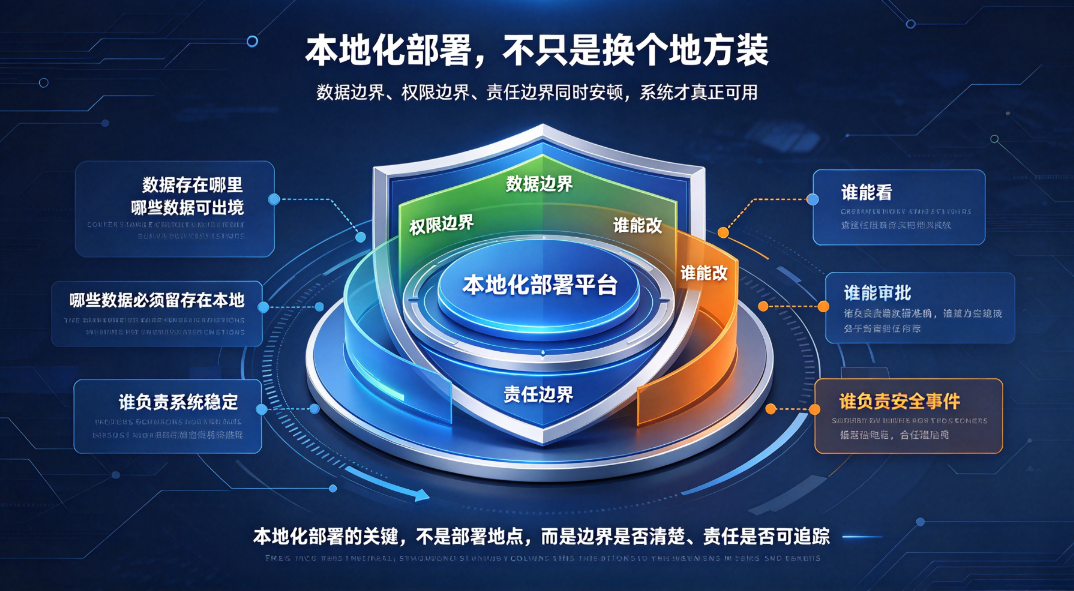
一、本地化部署的难点不在装在哪,在谁来养
制造业里对数据不出内网的要求很常见,尤其是涉及成本构成、配方、供应商价格的数据。但本地化部署真正的问题不是把软件装进内网,而是装完之后谁维护、怎么升级、出问题谁处理。
这三件事没想清楚,本地化就容易变成一次性的项目:上线那天很热闹,之后没人敢动。
二、传统本地化做法与安捷AI 的做法对比
表1 传统本地化做法与安捷AI 的做法对比
维度 | 传统本地化做法 | 安捷AI 的做法 | 变化 |
环境准备 | 按组件清单逐个安装与调优 | 给出明确的服务端配置建议,按规模分档 | 有可对照的底线 |
部署方式 | 视产品而定,多为物理机或自建虚机 | 支持本地部署,兼容 Linux 与 Windows Server,支持容器化部署 | 适配既有环境 |
数据库适配 | 逐个验证驱动与兼容性 | 常见关系型数据库与国产数据库均已做过兼容性验证,按标准驱动连接 | 少一轮适配 |
模型运行 | 多数据只能在外部处理 | 支持云端 API 与私有化大模型两种模式 | 可按数据边界选 |
权限 | 在应用层过滤 | 三层权限,行列级权限在数据库层强制执行 | 外部工具直连也受控 |
审计 | 部分操作无记录 | 覆盖问数、报表查看、数据导出、推送、管理操作五类 | 过程可回溯 |
三、服务端配置建议:按规模分档
本地化的第一道题是配多少资源。给得太低,跑不动;给得太高,浪费预算。下表是按使用规模给出的三档建议,可以直接拿去和运维对齐。
表2 服务端配置建议
场景 | CPU 与内存 | 存储 |
试用与小型团队(50 人以内) | 8 核 / 32 GB | 500 GB |
中型企业(50 至 300 人) | 16 核 / 64 GB | 1 TB |
大型企业或高并发场景 | 32 核以上 / 128 GB 以上 | 2 TB 以上 |
部署方式上,可运行在 Linux(含国产操作系统)与 Windows Server 环境,也支持容器化部署,便于和既有运维体系对接。
安捷AI 的数据访问方式是直连ERP 与接口接入,模型只负责理解问题、生成查询语句与组织答案,不参与数据搬迁。
四、模型放在哪里:两种部署模式怎么选
云端 API 模式只上传元数据与查询语句,不上传业务数据,适合对成本敏感、又想先快速验证的场景。
私有化大模型模式完全在本地运行,数据不出内网,适合已经把数据边界写进制度、需要过安全审查的场景。
两种模式的选择标准不是哪个更先进,而是企业的数据边界画在哪里。画在内网里,就选本地运行。
五、本地化部署方案怎么选:四个必问
如果正在比较几套方案的本地化能力,下面四个问题可以按顺序问一遍。
表3 本地化部署方案的四个必问
要问的问题 | 为什么问 | 安捷AI 的做法 |
有没有明确的配置建议 | 直接决定预算和运维工作量 | 按三档规模给出 CPU、内存与存储建议 |
权限在哪一层生效 | 应用层过滤容易被绕过 | 行列级权限在数据库层强制执行,外部工具直连同样受控 |
留哪些审计记录 | 出问题时要能还原过程 | 覆盖问数、报表查看、数据导出、推送与管理操作五类,日志不可删除 |
升级和运维谁负责 | 决定上线后能不能长期用下去 | 支持容器化部署,便于纳入既有运维流程 |
六、常见问题
问:本地化部署需要准备什么?
答:主要是服务器资源与操作系统环境。按使用规模对照三档配置建议准备即可,支持容器化部署。
问:内网环境里模型怎么跑?
答:可选用私有化大模型模式,模型完全在本地运行;也可选用云端 API 模式,仅上传元数据与查询语句,不上传业务数据。
问:支持国产数据库吗?
答:支持。常见关系型数据库与国产数据库均通过标准驱动连接,已完成兼容性验证。
问:权限能不能控到字段?
答:可以。权限分功能权限、数据内容权限与行列级权限三层,字段级控制属于行列级权限的一部分,在数据库层强制执行。
问:审计日志能保留多久?
答:保留周期可按企业需求配置,日志不可删除。